OpenAIが、自社のAIモデルを組織的に「コピー」しようとするキャンペーンを検知・阻止したと公表しました。技術的な話に聞こえますが、この件がいま話題になっている背景には「AIの使い方を巡るルールが急速に厳格化されている」という流れがあります。この記事では、何が起きたのかをかみ砕いて整理し、ChatGPTを業務で使っている会社(あるいはこれから使おうとしている会社)が確認しておきたい利用ルールのポイントを整理します。
何が起きたのか——「モデル蒸留」という手口
今回OpenAIが阻止したのは、「モデル蒸留(model distillation)」と呼ばれる手法を使った組織的な不正利用です。モデル蒸留とは、既存のAIに大量の質問を投げかけ、その回答パターンを学習させることで「似た性能を持つ別のAI」を作る技術的な手法のことです。要するに、OpenAIが膨大なコストをかけて開発したAIの「思考パターン」を、正規の開発プロセスを踏まずに引き出そうとする行為です。
OpenAIは今回、複数のアカウントが連携してこの抽出を試みていたことを検知し、該当アカウントを停止するとともに防御策を強化したと説明しています。公表の意図のひとつは「こういう行為は検知できている」というメッセージで、同種の試みへの抑止でもあります。この動きは、AI企業が知的財産の保護を競争上の優先事項として扱い始めたシグナルでもあります。モデルそのものの価値が上がるにつれて、利用規約の執行も以前より積極的になっていく可能性が高いです。
中小企業には直接関係ない……は誤解
「モデルをコピーしようなんて思っていないから自分たちには関係ない」と感じた方も多いでしょう。確かに今回摘発されたのは組織的な悪意ある行為です。ただ、この件を機に注目したいのは「ChatGPTの利用規約が想定より細かい」という点です。
たとえば、OpenAIの利用規約には「出力を使って競合モデルを学習させることの禁止」が明記されています。これは技術者だけに向けたルールではなく、業務でChatGPTを使うすべてのユーザーに適用されます。「毎日使っているけれど規約は読んでいない」という状態は、知らないうちにリスクを抱えている状態と言えます。利用規約違反が発覚した場合、アカウント停止という直接的な影響だけでなく、会社の信用リスクにもつながります。
ChatGPT(OpenAIが提供するAIチャットサービス)には、ブラウザから使う「ChatGPT」と、システムに組み込む「API(アプリケーション連携用の接続口)」の2種類のアクセス方法があります。それぞれ適用されるポリシーが異なる部分があり、API経由で利用している場合は別途「利用ポリシー」も確認する必要があります。どちらを使っているかによって、確認すべき規約のページが変わる点は覚えておいてください。
中小企業が知らずに踏みやすいグレーゾーン
規約違反とまで言えなくても「後でリスクになりやすいパターン」は実務の中に潜んでいます。以下は、従業員20〜50人規模の会社でよく見られる使い方を整理したものです。自社の状況と照らし合わせてみてください。
| 利用パターン | リスクの内容 | 対処の考え方 |
|---|---|---|
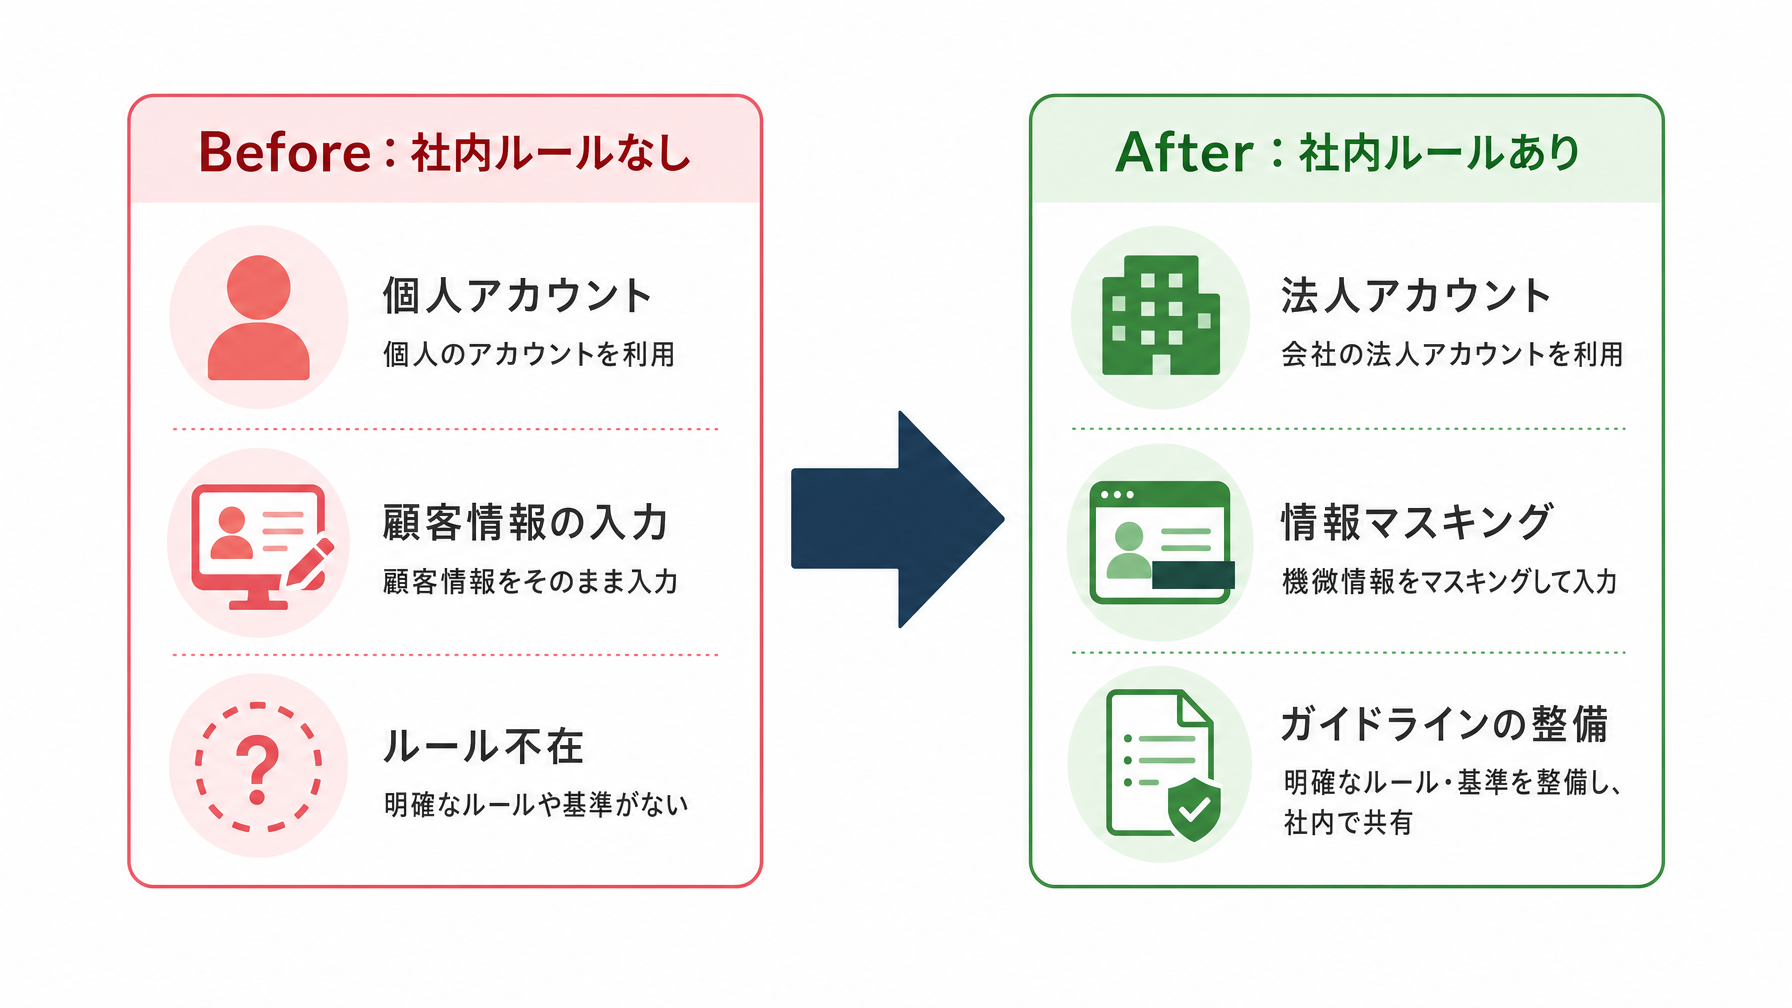
| 社員が個人アカウントで業務データを入力 | データが学習に使われる可能性、情報漏えいリスク | 業務利用はTeamプランまたはAPIに統一 |
| ChatGPTの回答をそのまま社外文書に使用 | 著作権の帰属が曖昧、誤情報の外部流出 | 必ず人が確認・編集した上で使用 |
| 出力を使って別のAIを追加学習させる | 利用規約上の明示的な禁止事項に抵触する可能性 | 自社AIの開発・学習には別途確認が必要 |
| 顧客情報を含む文章をそのまま入力 | 個人情報保護法・契約上の守秘義務と抵触するリスク | 固有名詞・個人情報は削除してから使用 |
| ルールなしに現場任せで利用が広がっている | 利用方法が属人化し、トラブル時に組織が対応できない | 最低限の社内ガイドラインを用意する |
たとえば、営業担当3人のチームが顧客の課題をまとめたメモをそのままChatGPTに貼り付けて提案書の下書きを作っているケースは、実際によくある光景です。業務効率は上がりますが、顧客名や具体的な取引内容が含まれたまま入力していれば、守秘義務やプライバシーポリシーの観点から問題になる可能性があります。「効率化のつもりが契約違反につながった」という事態は、社内ルールがないまま現場の判断に任せていると起きやすいです。
社内ルールを整備するのに「完璧さ」は不要
ここまで読んで「社内ルールを整備しなければ」と感じた方に伝えたいのは、最初から完璧なガイドラインを作る必要はないということです。ChatGPTの使い方ガイドでも触れているように、まず「何を入れてはいけないか」だけを決める1枚のルールシートから始めるのが現実的です。
具体的には、以下の2点を社内で合意するだけでも大きく変わります。一つは「個人情報・顧客情報・社外秘の情報は入力しない」というラインを引くこと。もう一つは「業務利用は会社が契約したアカウントを使う」という原則を決めることです。ChatGPTの無料プランや個人プランは、デフォルトの設定では入力したデータがAIの改善に使われる可能性があります。一方、法人向けの「ChatGPT Team」や「ChatGPT Enterprise」では、学習への使用をオプトアウトできる設定が用意されています。料金はTeamプランで1ユーザーあたり月額約30ドル(2026年10月時点)が目安です。
また、現場担当者がプロンプトを書く際の工夫でも情報管理のリスクは下げられます。プロンプトの書き方ガイドで解説しているように、顧客名を「A社」に置き換えるだけでも情報特定のリスクは大幅に減ります。大きなシステム投資をしなくても、使い方の工夫でカバーできる部分は多いです。
この流れがこれから何を意味するか
OpenAIが今回のケースを公表したことには、技術的な対処以上の意味があります。AI企業が「利用規約の執行を本格化している」というシグナルを市場に向けて発信したと読むこともできます。実際、OpenAIに限らず主要なAI事業者はここ1〜2年で利用ポリシーの更新頻度を上げており、禁止事項の記述も以前より詳細になっています。
中小企業にとってのリスクは、大企業のような法務部門が常時チェックしていないぶん「気づかずに規約が変わっていた」という状況になりやすい点です。年に1度でもよいので、使っているAIサービスの利用規約ページを確認する習慣をつけることが、今後のリスク管理として有効です。利用規約の変更は、多くの場合メールで通知されますが、読まれずに流れることも少なくありません。「通知メールを受け取る担当者を決めておく」だけでも対応のスピードは変わります。
まとめ
AIが業務の一部に溶け込んでいくほど、使い方のルールが問われる場面は増えます。今回のOpenAIの対応は「悪意ある組織への対処」ですが、その背景にある「利用規約の厳格化」という流れは、普通に業務でChatGPTを使っている会社にも無関係ではありません。完全なガイドラインを今すぐ作る必要はありませんが、「何を入れてはいけないか」「どのアカウントで使うか」の2点だけでも社内で合意しておく価値はあります。自社のAI利用が現状どのような状態にあるか、一度棚卸しするきっかけにしてみてください。
もし「社内ルールをどこから作ればよいか分からない」という場合は、AI導入の相談窓口に問い合わせてみることも一つの選択肢です。