「AIで採用や評価を効率化したい」と考える人事担当者は増えています。ところが実際に動き始めると、AIそのものより先に別の問題が立ちふさがります。それが「データ整備の壁」です。人事管理クラウド「カオナビ」が2026年9月に開催した研修プログラム「サマースクール」では、延べ226名の人事担当者がこの壁と向き合い、それぞれの実践ロードマップを作りました。その取り組みが浮き彫りにしたのは、AIの導入可否よりも「自社のデータがどんな状態にあるか」を先に見ておくことの重要性です。この記事では、そのロードマップから読み取れる準備の進め方を、中小企業の人事担当者が自社で使える形に整理します。
なぜAI導入より「データ整備」が先に来るのか
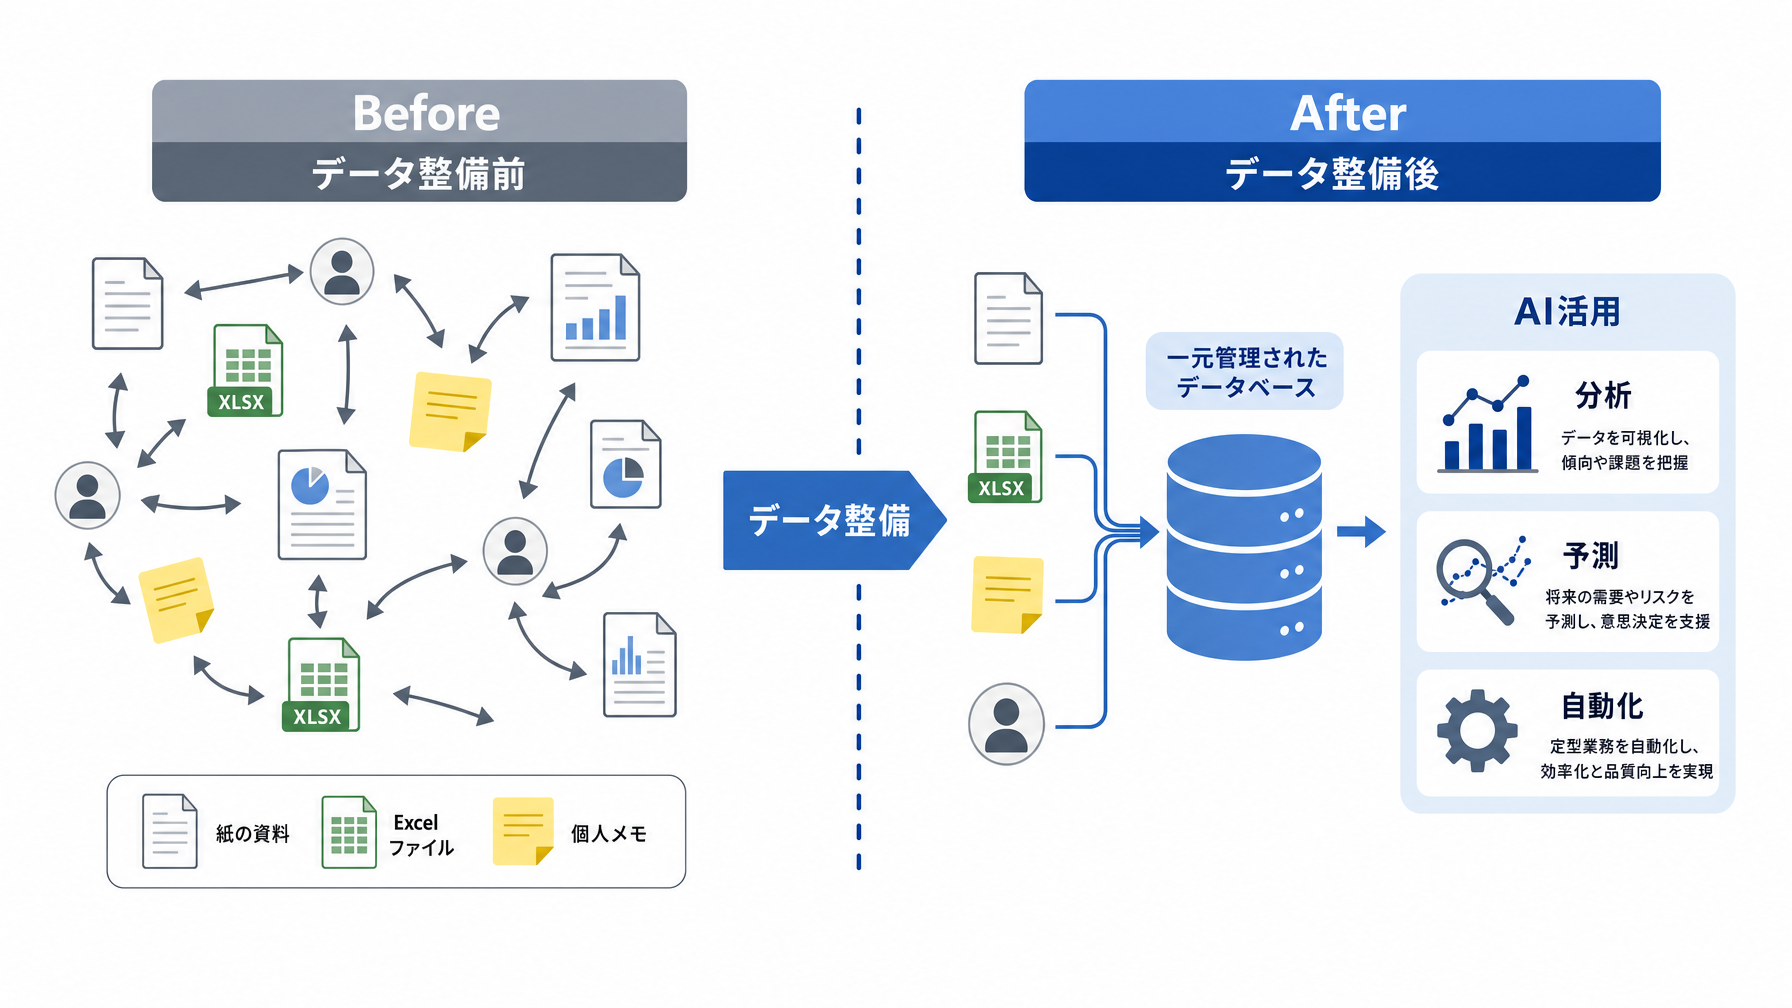
人事AIと聞いて思い浮かぶのは、採用候補者のスコアリングや、離職リスクの予測、評価フィードバックの自動生成といった機能でしょう。ただ、これらはどれも「入力できるデータがある」ことを前提にしています。AIはデータを学習・参照して回答を出すしくみ(大量の情報から傾向を読み取って判断を補助するツール)であるため、そもそものデータが分散していたり、表記が統一されていなかったりすると、まともに動かせません。
たとえば従業員50人の製造業で、社員の勤務記録はExcel、評価履歴は紙、資格情報は担当者のメモというケースを想像してください。このままAIツールを導入しても、データの読み込み先がバラバラなため、「誰がいつ何を担当していたか」という基本的な問いにさえ答えられません。AIのせいではなく、データの状態の問題です。カオナビのサマースクールで226名がぶつかった「最初の壁」は、まさにここです。
人事データの「整備前」と「整備後」でできることの差
ここで、人事データの整備状況によってAI活用でできることがどう変わるかを整理してみます。以下は一般的な人事業務を対象にした比較です。
| 整備状況 | AIでできること | 難しいこと |
|---|---|---|
| データがほぼ未整備(紙・Excel混在) | 個別文書の要約・下書き生成程度 | 社員横断の分析、予測、自動集計 |
| データが一部デジタル化されている | 特定部署のシフト最適化・FAQ対応補助 | 全社規模の傾向把握、評価の一貫性確認 |
| データが一元管理されている | 離職予測・採用スコアリング・人材配置提案 | ほぼなし(精度の改善は継続的に必要) |
この表からわかるように、「とりあえずAIを入れれば何とかなる」という発想は機能しません。一方、「完全に整備できてから」と待っていると着手が遅れます。整備しながらできることから始める、という視点が現実的です。
226名のロードマップから見えた3つのパターン
カオナビのサマースクールでは、参加者が自社の現状を棚卸ししたうえで、それぞれの状況に合った実践ロードマップを作成しました。参加者のアクションを大きく分類すると、会社の規模や人事データの管理状況によって着手点が3つのパターンに分かれてきます。
パターン①:データが紙やExcel中心の会社
最初の一手は「どこに何のデータがあるか」の棚卸しです。従業員の基本情報・評価履歴・スキル情報・労務情報を洗い出し、どれが紙でどれがデジタルかを整理します。全部をいきなりシステムに移そうとすると担当者がつぶれるので、AI活用で最も使いたい用途(例:採用面接の記録分析など)から逆算して優先順位をつけます。
パターン②:データはあるが散在している会社
Excel管理でデータはあるものの、ファイルが担当者ごとにバラバラという状態がここに該当します。この場合は「表記の統一」と「管理場所の集約」が先決です。部署名・役職名・入社日の書き方が担当者によってバラバラになっていると、AIで集計しても数字が合いません。まずフォーマットを揃えるだけでも、AIに渡せるデータの質が変わります。
パターン③:人事システムを入れているが活用しきれていない会社
システム自体はある。でも実際には紙の書類と並行運用になっていて、システム内のデータが最新ではない。このパターンが中小企業では意外と多いです。ここでは「システムへの入力を習慣化する運用ルール作り」が優先課題になります。AIを使う前に、まず現行システムに正しいデータが入っている状態を作ることが目標です。
自社のデータ整備状況を棚卸しする方法
「うちはどのパターンか」を判断するために、人事担当者が一人でも着手できる棚卸しの進め方を紹介します。難しく考える必要はなく、A4の紙1枚でも十分です。
確認すべき軸は大きく4つです。「従業員の基本情報(氏名・入社日・所属・役職)」「評価・スキル情報(過去の評価記録・保有資格・担当業務)」「労務情報(勤怠データ・給与履歴・契約形態)」「採用情報(応募者データ・面接記録・採用理由)」。それぞれについて「紙/Excel/システム/管理なし」のどれかに分類するだけで、自社の現在地が見えてきます。
営業7人・バックオフィス3人という計10人規模のサービス業であれば、このチェックは半日もあれば終わります。「評価記録だけは紙のまま」「採用データは前任者が退職したときに消えた」という具体的な課題が見つかれば、次のステップが明確になります。ChatGPTの活用ガイドでも触れているように、AIに仕事をさせるためには「渡せるデータがある状態」を先に作ることが前提です。
データ整備を進めるときにはまる落とし穴
ロードマップを作る際に見落としやすい点がいくつかあります。
一つ目は「完璧なデータを目指しすぎる」こと。従業員全員の10年分の評価データをすべてシステムに移してからAIを使おう、とすると着手まで1年以上かかります。AI活用で最初にやりたいこと(例:採用候補者の評価基準の統一)に絞って、そこに必要なデータだけ先に整えるほうが現実的です。
二つ目は「整備した後の運用ルールを決めていない」こと。一度きれいにしても、入力する担当者が変わるたびにバラバラになっていきます。「誰が・いつ・どこに入力するか」のルールを簡単なものでも決めておかないと、せっかく整えたデータがすぐに崩れます。
三つ目は「個人情報の取り扱いを後回しにする」こと。人事データは従業員の個人情報を多く含むため、どのシステムやAIツールにデータを渡すかは慎重に確認が必要です。クラウド型のAIツールにそのまま社員名簿を貼り付けることはリスクを伴います。プロンプトの書き方ガイドでも個人情報の扱いについて基本的な考え方を整理しているので、ツールに渡すデータの範囲を決める際の参考にしてください。
どこから手をつければいいか分からない場合
ここまで読んで「うちの会社はどのパターンかよく分からない」「棚卸しを始めようとしたが途中で迷った」という状況になることがあります。データ整備はあくまで手段であり、どこから優先するかは会社の規模や人事担当の人数、今抱えている課題によって変わります。
採用に課題を感じているなら採用データから、評価の公平性が問題なら評価記録から。「一番痛い課題」の周辺データを先に整えると、ロードマップが具体的になりやすいです。自社の状況を整理したうえで判断しきれない部分があれば、AI導入・社内研修に関する相談窓口を活用することも選択肢の一つです。
まとめ
人事AIの導入を検討するとき、「どのツールを選ぶか」より「自社のデータが今どんな状態にあるか」を先に把握することが、結果的に近道になります。226名が取り組んだロードマップが示すのは、完璧なデータ整備を目指すことではなく、「最初にやりたいAI活用」から逆算して必要な範囲だけ先に整えるという考え方です。自社の人事データが今どこにあり、どの形式で管理されているかを一度棚卸ししてみることが、AIを実際に使い始めるための具体的な一歩になります。