自社のホームページに書いた文章や商品説明が、知らないうちにAIの学習データに使われているかもしれない。そう聞いても「うちには関係ない」と思う中小企業の担当者は多いかもしれませんが、OpenAIが2024年以降に打ち出した方針により、Webサイト運営者が自分の意思を明示できる仕組みが整ってきました。この記事では、その仕組みの概要と、自社サイトに設定するかどうかを判断するための材料を整理します。
そもそも何が起きているのか
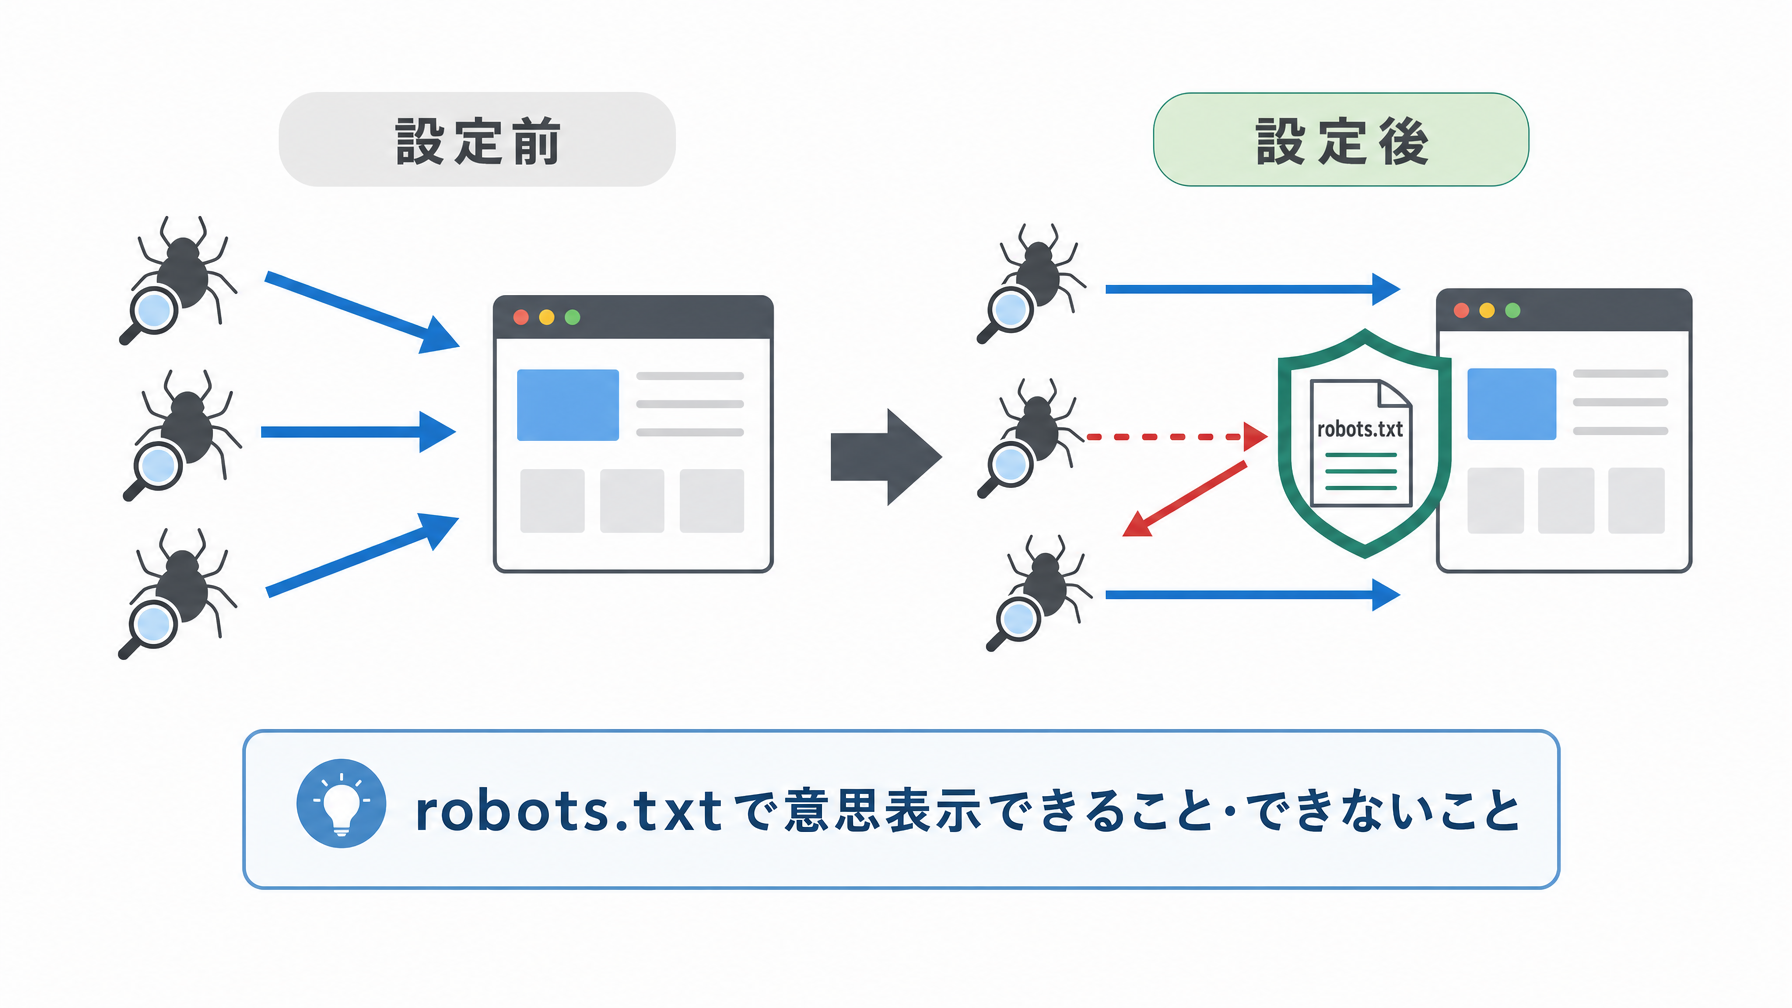
AIの言語モデルは、インターネット上の膨大なテキストを学習データとして取り込むことで作られています。つまり、誰でも閲覧できる状態で公開されているWebサイトのテキストは、原則としてAI企業のクローラー(自動巡回ロボット)が収集し、学習に使う可能性があります。ブログ記事、会社概要、採用ページ、商品説明など、自社サイトに書いたあらゆる文章が対象になりえます。
OpenAIは、このクローラーによる収集とAI学習の可否を、Webサイト側が設定ファイルで指定できる仕組みに対応すると発表しました。対応するファイルが「robots.txt(ロボッツ・テキスト)」です。robots.txtとは、Webサイトのサーバー上に置かれる小さなテキストファイルで、検索エンジンのクローラーなどに「このページは収集しても良い/良くない」と伝えるためのものです。Googleの検索インデックスでも長年使われてきた仕組みで、AI学習への応用が広がっています。
設定で何ができるか、何ができないか
robots.txtに記述できる内容は大きく分けて二つあります。一つはサイト全体のクロール(収集)を拒否すること、もう一つはAI学習への使用だけを拒否することです。OpenAIの場合、クローラーの名称が「GPTBot」であり、この識別名を使って制御します。
設定そのものは難しくありませんが、重要な前提として「robots.txtの指示はあくまで紳士協定」である点は理解しておく必要があります。技術的に強制する仕組みではなく、対応を表明した企業だけが従います。OpenAI、Google、Anthropicなど主要なAI企業は対応を表明していますが、すべてのクローラーが従うわけではありません。「設定すれば完全にブロックできる」と思い込まずに、「誠実に対応している企業には意思表示できる」という位置づけで捉えるのが適切です。
設定コードと手順の整理
実際の設定内容を確認しましょう。robots.txtはサーバーのルートディレクトリ(例:https://example.com/robots.txt)に設置するテキストファイルです。以下に代表的なAIクローラーへの設定例を示します。
# OpenAIのクローラーをAI学習から除外
User-agent: GPTBot
Disallow: /

# Anthropicのクローラーを除外
User-agent: Claude-Web
Disallow: /

# Google拡張AIを除外(Googleの検索インデックスには影響しない)
User-agent: Google-Extended
Disallow: /
上の記述は「サイト全体を対象に、それぞれのクローラーの収集を拒否する」という意味になります。サイト全体ではなく特定のページだけ除外したい場合は、Disallow: /blog/ のように対象パスを絞ることも可能です。
作業の難易度という観点で整理すると、次のようになります。
| 作業内容 | 難易度 | エンジニア不要か |
|---|---|---|
| 既存のrobots.txtに追記する | 低 | ほぼ可能 |
| robots.txtを新規作成してアップロード | 低〜中 | FTPやCPanelが使えれば可能 |
| WordPressのSEOプラグイン(Yoast等)から設定 | 低 | 可能 |
| サーバーのファイル管理画面から操作 | 中 | 可能(管理画面によって差がある) |
| 既存のrobots.txtを確認する方法がわからない | 中 | IT担当や制作会社に確認を推奨 |
WordPressを使っているサイトであれば、「Yoast SEO」などのプラグインがrobots.txtの編集画面を提供しているケースが多く、管理画面から直接編集できます。自社でホームページを管理している担当者が慣れていれば、30分程度で対応できる作業量です。
設定するかどうか、どう判断するか
すべての企業が設定すべき、とは言い切れません。判断の材料として、次の観点で自社の状況を見てみてください。
まず「自社サイトのコンテンツに競争優位がどの程度含まれているか」という視点があります。たとえば、独自の技術的な知見を書いたブログ記事、長年かけて蓄積した専門的なコラム、独自の価格体系や商品説明などを豊富に持つサイトは、AI学習への提供に慎重になる理由があります。一方、会社の基本情報や採用情報程度のシンプルなサイトであれば、緊急性は低いかもしれません。
具体的なシナリオで考えてみましょう。従業員40人の建設会社が、施工事例や専門的な工法の説明をサイトに豊富に掲載しているとします。このコンテンツが競合他社への提案書作成にAIを使う際の参考データとして取り込まれた場合、間接的に自社の情報が競合の武器になるリスクを考えると、拒否設定を入れる動機は十分あります。
逆に、ECサイトを運営していてGoogle検索からの流入が売上の柱になっている場合は、AIクローラーへの対応を慎重に選ぶ必要があります。GoogleやBingがAI機能を検索に統合しており、AI向けクローラーをブロックすると将来的に検索結果での露出に影響が出る可能性もゼロではないからです。この点は現時点では流動的であり、各社の方針も変化していくため、定期的に確認することが現実的な対応になります。
国内の対応状況と今後の流れ
国内の中小企業サイトでAI学習拒否のrobots.txt設定がどの程度普及しているかを調べると、2024年時点で大企業のメディアサイトや出版社系では設定が進んでいる一方、従業員100人以下の中小企業サイトではほとんど設定されていないのが実態です。認知度そのものが低く、「そういう設定があること自体を知らなかった」という担当者が大半を占めます。
一方、著作権とAI学習の関係については国内外で議論が続いており、文化庁や内閣府も検討を進めています。現時点では「公開されたデータは学習に使える」という立場が日本の著作権法の解釈として強いですが、今後の法改正や判例次第で状況が変わる可能性は十分あります。その意味で、今から自社の意思表示の仕組みを理解しておくことは、先手を打つという観点でも意味があります。
ChatGPTの使い方ガイドでも触れているように、AIツールを「使う側」として活用するのと、「提供元のデータ源にされる側」として対処するのは、まったく別の問題です。自社がどちらの立場でどう動くかを分けて考えることが、これからのWeb運営では重要になってきます。
また、プロンプトの書き方を工夫して業務効率を上げることと、自社の知的財産をどう守るかは並行して考えるべきテーマです。プロンプトの書き方ガイドでも紹介しているように、AIを上手く使うためのスキルを社内で育てながら、同時に自社コンテンツの扱いについて方針を決めておくのが、バランスの取れた対応といえます。
まとめ
robots.txtへのAI学習拒否設定は、技術的には難しくなく、意思さえ固まれば数十分で着手できる作業です。ただし、効果の範囲は「対応を表明しているAI企業への意思表示」にとどまる点と、検索流入への影響が将来的にゼロかどうかはまだ不確実な点を理解したうえで判断してください。
自社サイトのコンテンツに専門性や競争優位が凝縮されているなら設定を検討する価値があり、シンプルな会社紹介サイトであれば優先度は低い、というのが現時点での判断軸です。まず自社のrobots.txtが今どうなっているかを確認することから始めてみてください。https://自社ドメイン/robots.txt をブラウザで開けば、現在の設定内容を誰でも確認できます。
AI活用と自社コンテンツ保護の方針について、どう整理すればよいか迷う場合は、お気軽にご相談ください。